បណ្ណាល័យឌីជីថល PTEC
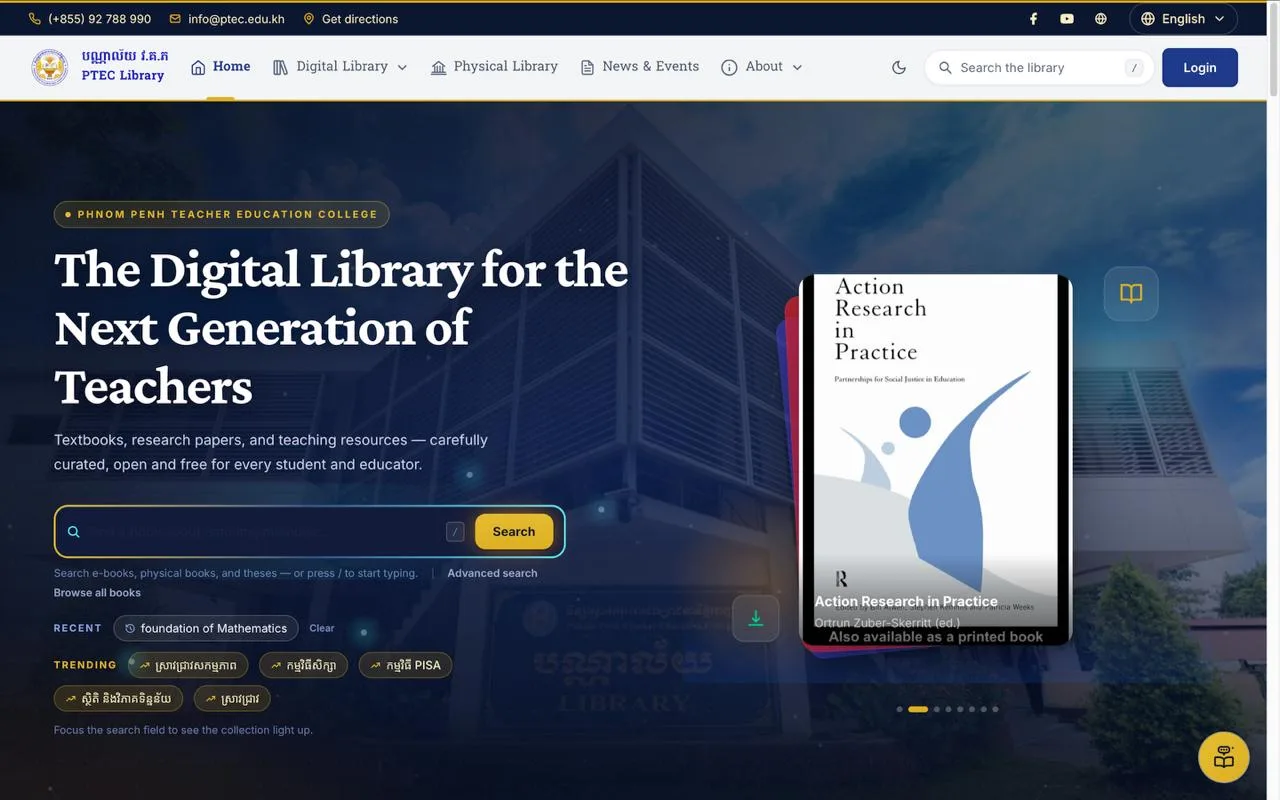
ឃ្លាំងឯកសារសិក្សាពីរភាសាសម្រាប់វិទ្យាស្ថានគរុកោសល្យរាជធានីភ្នំពេញ — សៀវភៅ និក្ខេបបទ ស្នាដៃស្រាវជ្រាវ និងផ្លូវសិក្សាដែលបានរៀបចំ អាចអានតាមអ៊ីនធឺណិត ដំឡើងជាកម្មវិធី និងស្វែងរកបានទាំងភាសាខ្មែរ និងអង់គ្លេស។
បញ្ហា
ឯកសារសិក្សានៅវិទ្យាស្ថានបណ្តុះបណ្តាលគ្រូខ្ចាត់ខ្ចាយ៖ សៀវភៅបោះពុម្ពនៅលើធ្នើ កម្មវិធីសិក្សានៅក្នុងឧបករណ៍ផ្ទាល់ខ្លួន និក្ខេបបទដែលចងក្រងម្តងហើយកម្រត្រូវបានបើកមើលម្តងទៀត។ និស្សិតដែលរកឯកសារមិនឃើញ ស្ថិតក្នុងស្ថានភាពដូចគ្នានឹងឯកសារនោះមិនមានដែរ។ ហើយកំណត់ត្រាកាតាឡុកដែលមានតែក្នុងប្រព័ន្ធខាងក្នុង ដោះស្រាយបញ្ហារបស់បណ្ណារក្ស មិនមែនរបស់អ្នកអានទេ។
វិធីសាស្ត្រ
គេហទំព័រពីរភាសាតែមួយដែលផ្ទុកឯកសារសម្រាំងទាំងមូល — ទាំងឌីជីថល និងរូបវន្ត ទាំងស្នាដៃរបស់វិទ្យាស្ថាន និងឯកសារដែលផ្ទុកជូន — ដោយបញ្ជាក់សិទ្ធិនៅលើធាតុនីមួយៗ។ អ្នកអានរុករក និងស្វែងរកបានដោយមិនចាំបាច់មានគណនី។ គណនីបន្ថែមបញ្ជីរក្សាទុក និងការអានក្រៅបណ្តាញ។ អ្វីៗដែល crawler អាចចូលបាន ត្រូវបានពិពណ៌នាក្នុង structured data និងឯកសារសម្រាប់ម៉ាស៊ីន ដូច្នេះឯកសារសម្រាំងអាចរកឃើញពីខាងក្រៅគេហទំព័រផងដែរ។
អ្វីដែលវាធ្វើឥឡូវនេះ
វេទិកាដំណើរការនៅ library.ptec.edu.kh ហើយបម្រើឯកសារសម្រាំងរបស់វិទ្យាស្ថានជាសាធារណៈ ទាំងភាសាខ្មែរ និងអង់គ្លេស។ គិតត្រឹមថ្ងៃទី ៣១ ខែកក្កដា ឆ្នាំ ២០២៦ វាបានបោះផ្សាយឯកសារឌីជីថល ១១៤ កំណត់ត្រាកាតាឡុករូបវន្តសកម្ម ៧ និងផ្លូវសិក្សា ៤ — ជាតួលេខដែលគេហទំព័រខ្លួនឯងរាយការណ៍នៅក្នុង llms.txt សាធារណៈរបស់វា។ វាដំឡើងជាកម្មវិធីបាន រក្សាសៀវភៅឱ្យអានបានពេលគ្មានអ៊ីនធឺណិត និងពិពណ៌នាផ្នែកសាធារណៈបានល្អគ្រប់គ្រាន់ ដើម្បីឱ្យម៉ាស៊ីនស្វែងរក និងប្រព័ន្ធ AI អាចដកស្រង់កំណត់ត្រានីមួយៗ មិនមែនតែទំព័រដើមទេ។
114 ឯកសារឌីជីថលដែលបានបោះផ្សាយ
ទិដ្ឋភាពទូទៅ
បណ្ណាល័យឌីជីថល PTEC បង្ហាញឯកសារបង្រៀន និងស្រាវជ្រាវរបស់វិទ្យាស្ថាននៅ library.ptec.edu.kh។ វាគ្របដណ្តប់ឯកសារប្រាំប្រភេទ — សៀវភៅឌីជីថល កាតាឡុកបណ្ណាល័យរូបវន្ត និក្ខេបបទនិស្សិត ស្នាដៃស្រាវជ្រាវ និងផ្លូវសិក្សាដែលបានរៀបចំ — ហើយក៏ចងក្រងព័ត៌មានអំពីបណ្ណាល័យរូបវន្តទៀតផង ដូច្នេះសេវាតាមអ៊ីនធឺណិត និងសេវានៅនឹងកន្លែងក្លាយជាសេវាតែមួយ។
គ្រប់ផ្នែកសាធារណៈមានទាំងភាសាអង់គ្លេស និងភាសាខ្មែរនៅក្រោម /km ដោយមាន hreflang យោងគ្នាទៅវិញទៅមក ហើយ URL អង់គ្លេសជា canonical។ គេហទំព័រអាចដំឡើងជា PWA និងរក្សាសៀវភៅដែលបានរក្សាទុកឱ្យអានបានពេលគ្មានអ៊ីនធឺណិត។
សម្រាប់អ្នកណា
គរុនិស្សិត សាស្ត្រាចារ្យ និងបណ្ណារក្សនៅ PTEC ព្រមទាំងអ្នកស្រាវជ្រាវអំពីការបណ្តុះបណ្តាលគ្រូនៅកម្ពុជា។ ផ្នែកសាធារណៈបើកចំហដោយមិនចាំបាច់មានគណនី។ គណនីអ្នកអានបន្ថែមប្រវត្តិរូប បញ្ជីរក្សាទុក និងការអានពេលគ្មានអ៊ីនធឺណិត។
គោលដៅ
បណ្ណាល័យប្រកាសបេសកកម្មរបស់ខ្លួននៅក្នុងឯកសារ /llms.txt ដែលអាចអានដោយម៉ាស៊ីន៖ រក្សាទុក រៀបចំ និងចែករំលែកឯកសារបង្រៀន និងស្រាវជ្រាវរបស់វិទ្យាស្ថាន និងបង្កើនលទ្ធភាពទទួលបានឯកសារបណ្តុះបណ្តាលគ្រូ ស្នាដៃស្រាវជ្រាវនិស្សិត និងព័ត៌មានកាតាឡុក សម្រាប់សហគមន៍ PTEC និងសាធារណជនទូទៅ។ វេទិកានេះត្រូវបានបង្កើតឡើងដើម្បីបម្រើបេសកកម្មនោះដល់អ្នកទស្សនាបីប្រភេទក្នុងពេលតែមួយ — អ្នកអានជាមនុស្ស ម៉ាស៊ីនស្វែងរក និងប្រព័ន្ធ AI ដែលឆ្លើយសំណួរ។
តួនាទីរបស់ខ្ញុំ
ខ្ញុំបង្កើត និងថែទាំវេទិកានេះក្នុងនាមជាអ្នកអភិវឌ្ឍពេញលេញ (full-stack)។ អត្ថបទខាងក្រោមរៀបរាប់អំពីប្រព័ន្ធដូចដែលវាដំណើរការសព្វថ្ងៃ។ ការបែងចែកលម្អិតថានរណាធ្វើអ្វីពេញមួយដំណើរការគម្រោង មិនត្រូវបានអះអាងនៅទីនេះទេ។
ឧបសគ្គ
កត្តាកំណត់ពីរបានកំណត់ការសម្រេចចិត្តភាគច្រើនដែលមើលឃើញ។ ទីមួយ ឯកសារសម្រាំងមានសិទ្ធិចម្រុះ — ខ្លះជាស្នាដៃរបស់វិទ្យាស្ថានផ្ទាល់ ដែលអានបានដោយសេរី ខ្លះទៀតគ្រាន់តែជាទំព័រព័ត៌មានគន្ថនិទ្ទេសសម្រាប់អត្ថបទទស្សនាវដ្តីរបស់ភាគីទីបី ដែលអត្ថបទពេញស្ថិតនៅក្រោយរបាំងបង់ប្រាក់ — ដូច្នេះប្រព័ន្ធមិនអាចចាត់ទុក «មានកំណត់ត្រា» និង «ទាញយកបាន» ជារឿងតែមួយឡើយ។ ទីពីរ អ្នកអានប្រើទូរស័ព្ទ និងអ៊ីនធឺណិតមិនស្ថិតស្ថេរ ដែលជាហេតុផលឱ្យគេហទំព័រអាចដំឡើងបាន ប្រើ service worker សម្រាប់ cache និងចាត់ទុក «រក្សាទុកសម្រាប់អានក្រៅបណ្តាញ» ជាទំព័រដាច់ដោយឡែក។
ការសម្រេចចិត្តលើ UX
កាតាឡុកត្រូវបានរៀបចំតាមអ្វីដែលអ្នកអានកំពុងស្វែងរក មិនមែនតាមរបៀបដែលទិន្នន័យត្រូវបានរក្សាទុកទេ៖ សៀវភៅ និក្ខេបបទ ស្នាដៃស្រាវជ្រាវ ផ្លូវសិក្សា និងកាតាឡុករូបវន្ត សុទ្ធតែជាច្រកចូលដាច់ដោយឡែក។ ទំព័រសៀវភៅបើកចេញជាមួយការពិពណ៌នាមុនគេ ដោយមានផ្ទាំងអាន និងផ្ទាំងមតិយោបល់នៅជាប់គ្នា ដូច្នេះអ្វីដែលអ្នកអានឃើញមុនគេគឺថាតើនេះជាសៀវភៅត្រឹមត្រូវឬអត់។ ផ្លូវសិក្សាមានវត្តមានព្រោះបញ្ជីសៀវភៅរាប់រយក្បាលមិនមែនជាកម្មវិធីសិក្សាទេ — វារៀបសៀវភៅ និងនិក្ខេបបទជាលំដាប់ជុំវិញប្រធានបទបណ្តុះបណ្តាលគ្រូជាក់ស្តែង។ ប៊ូតុងប្តូរភាសាស្ថិតនៅលើក្បាលទំព័រគ្រប់ទំព័រ ហើយរបារខាងក្រោមលើទូរស័ព្ទរក្សា ទំព័រដើម បណ្ណាល័យឌីជីថល ស្វែងរក ព័ត៌មាន និងប្រវត្តិរូប ឱ្យនៅជិតមេដៃ។
រចនាសម្ព័ន្ធប្រព័ន្ធ
កម្មវិធី Next.js ដាក់ដំណើរការលើ Vercel។ ទំព័រត្រូវបានបង្កើតជាមុន (prerender) និងធ្វើបច្ចុប្បន្នភាពក្នុងរយៈពេល ៣០០ វិនាទី — មើលឃើញលើ header ជា x-nextjs-prerender និង x-nextjs-stale-time — ដូច្នេះទំព័រកាតាឡុកបម្រើពី cache ដោយមិនចាស់យូរពេក។ Supabase ផ្តល់មូលដ្ឋានទិន្នន័យ និងឆានែល realtime។ ការបញ្ជូនឯកសារមិនមែនជាការងាររបស់កម្មវិធីទេ៖ គម្របសៀវភៅ និងឯកសារមកពី Cloudflare R2 និង Vercel Blob ដោយមានម៉ាស៊ីនផ្ទុកដាច់ដោយឡែកនៅខាងមុខ ដូច្នេះចរាចរណ៍ទាញយកមិនប្រកួតជាមួយការបង្ហាញទំព័រ។ ការចូលគណនីប្រើ Google OAuth ហើយ Cloudflare Turnstile ការពារទម្រង់បំពេញ។
ការសម្រេចចិត្តលើមូលដ្ឋានទិន្នន័យ
គំរូកំណត់ត្រាបែងចែកឯកសារចេញពីអ្នកនិពន្ធ និងប្រធានបទរបស់វា៖ អ្នកនិពន្ធ និងប្រធានបទមានទំព័ររុករករៀងៗខ្លួន មិនមែនត្រឹមអត្ថបទសេរីនៅលើកំណត់ត្រាទេ ដែលនេះជាហេតុធ្វើឱ្យ «ស្នាដៃផ្សេងទៀតរបស់អ្នកនិពន្ធនេះ» និង «ឯកសារផ្សេងទៀតក្នុងប្រធានបទនេះ» អាចធ្វើទៅបាន។ លេខសម្គាល់សិក្សា — DOI, ORCID, ISSN — ត្រូវបានផ្ទៀងផ្ទាត់មុនបោះផ្សាយ ដូច្នេះលេខសម្គាល់ណាដែលឡើងដល់ទំព័រសាធារណៈ គឺមានទម្រង់ត្រឹមត្រូវ។ សិទ្ធិក៏ស្ថិតនៅលើកំណត់ត្រាដែរ៖ ធាតុនីមួយៗមានអាជ្ញាបណ្ណ និងស្ថានភាពអានដោយសេរីរបស់ខ្លួន ហើយវេទិកាបញ្ជាក់ច្បាស់ថាខ្លួនជា «អ្នកផ្តល់» សៀវភៅភាគច្រើន មិនមែនជា «អ្នកបោះពុម្ពផ្សាយ» ទេ។
មុខងារសំខាន់
មុខងារខាងក្រោមគឺជាមុខងារដែលអ្នកអានប្រើពិតប្រាកដ។ មុខងារនីមួយៗអាចផ្ទៀងផ្ទាត់បានពីគេហទំព័រសាធារណៈ។
សុវត្ថិភាព
ក្បាលឆ្លើយតបត្រូវបានកំណត់តឹងរឹងដោយចេតនា៖ frame-ancestors 'none' ជាមួយ X-Frame-Options DENY, object-src 'none', form-action 'self', base-uri 'self', HSTS ជាមួយ preload និង Content-Security-Policy ដែលរាយបញ្ជីដើមកំណើតដែលអនុញ្ញាតទាំងអស់ ជាជាងពឹងលើ wildcard។ Cross-Origin-Opener-Policy គឺ same-origin-allow-popups — តឹងល្មមដើម្បីញែកទំព័រចេញ ប៉ុន្តែនៅតែអនុញ្ញាតឱ្យ popup ចូលគណនី Google ដំណើរការ — រួមជាមួយ Cross-Origin-Resource-Policy same-origin និង X-Permitted-Cross-Domain-Policies none។ robots.txt រារាំងទំព័ររដ្ឋបាល API ផ្ទាំងគ្រប់គ្រង ការផ្ទៀងផ្ទាត់គណនី និងបញ្ជីឯកជន មិនឱ្យចូលក្នុងលិបិក្រម។
លទ្ធភាពប្រើប្រាស់
គ្រប់ទំព័របើកចេញជាមួយតំណ «រំលងទៅមាតិកា»។ ភាសាទាំងពីរត្រូវបានសម្គាល់នៅកម្រិតឯកសារ និងមាន hreflang យោងគ្នាទៅវិញទៅមក ដូច្នេះឧបករណ៍ជំនួយប្តូរសំឡេងអានបានត្រឹមត្រូវ ជាជាងអានភាសាខ្មែរដោយសំឡេងអង់គ្លេស។ តំណដែលចេញក្រៅគេហទំព័រប្រកាសថាបើកក្នុងផ្ទាំងថ្មី ហើយរបារខាងក្រោមលើទូរស័ព្ទរក្សាទំហំប៉ះស្រួល។
SEO
SEO បច្ចេកទេសត្រូវបានចាត់ទុកជាមុខងារមួយ មិនមែនជារឿងបន្ថែមក្រោយទេ។ ទំព័រនានាបញ្ចេញ structured data — Library និង EducationalOrganization សម្រាប់ស្ថាប័ន, WebSite ជាមួយ SearchAction, Book និង ScholarlyArticle សម្រាប់កំណត់ត្រានីមួយៗ, BreadcrumbList សម្រាប់ទីតាំង និង FAQPage នៅទំព័រដើម។ Sitemap រាយភាសាទាំងពីរនៃ URL គ្រប់ទំព័រ ជាមួយ hreflang យោងគ្នា។ លើសពី SEO ធម្មតា គេហទំព័របោះផ្សាយ llms.txt៖ ជាឯកសារអត្ថបទសម្រាប់ប្រព័ន្ធ AI ដែលបញ្ជាក់អត្តសញ្ញាណស្ថាប័ន បេសកកម្ម ប្រភេទឯកសារ ចំនួនឯកសារបច្ចុប្បន្ន ជំហរស្តីពីសិទ្ធិ និងវិធីដកស្រង់ — ហើយ robots.txt អនុញ្ញាតឱ្យ crawler AI ជាក់លាក់ចូលផ្នែកសាធារណៈ ដោយបិទផ្នែករដ្ឋបាល API និងគណនី។
ដំណើរការ
ទំព័រកាតាឡុកត្រូវបានបង្កើតជាមុន និងធ្វើបច្ចុប្បន្នភាពរៀងរាល់ ៣០០ វិនាទី ជាជាងបង្កើតឡើងវិញរាល់សំណើ ដូច្នេះផ្លូវធម្មតាគឺជា cache hit។ រូបភាពគម្របត្រូវបានបម្រើជា WebP ដែលបង្កើតទុកជាមុនពីកន្លែងផ្ទុកវត្ថុ ជាជាងបំលែងទំហំតាមសំណើ។ Service worker ធ្វើ cache លើសំបកកម្មវិធី និងសៀវភៅដែលរក្សាទុក ដែលជាហេតុធ្វើឱ្យគេហទំព័រនៅប្រើបានពេលអ៊ីនធឺណិតដាច់ៗ មិនមែនតែពេលអ៊ីនធឺណិតលឿនទេ។
បញ្ហាប្រឈម
បញ្ហាពិបាកបំផុតនៅទីនេះមិនមែនជាបញ្ហាបច្ចេកទេសទេ។ បណ្ណាល័យដែលផ្ទុកសៀវភៅរបស់អ្នកដទៃ ត្រូវច្បាស់លាស់ថាខ្លួនជាអ្វី៖ PTEC ជាអ្នកផ្តល់សៀវភៅភាគច្រើន មិនមែនជាអ្នកបោះពុម្ពផ្សាយ ហើយស្នាដៃខ្លះគ្រាន់តែជាទំព័រដកស្រង់សម្រាប់អត្ថបទដែលត្រូវបង់ប្រាក់។ វេទិកាដាក់ភាពខុសគ្នានេះនៅលើកំណត់ត្រានីមួយៗ — អាជ្ញាបណ្ណ និងស្ថានភាពអានដោយសេរីរបស់វា — និងបញ្ជាក់ជាសាធារណៈ ដូច្នេះទាំងអ្នកអាន ទាំង crawler មិនត្រូវបានយល់ច្រឡំអំពីអ្វីដែលអាចទាញយកបានឡើយ។
ការកែលម្អបន្ទាប់
ឯកសារសម្រាំងផ្នែកនិក្ខេបបទ និងស្នាដៃស្រាវជ្រាវនៅតូចបើធៀបនឹងសៀវភៅដែលបានបោះផ្សាយ ដូច្នេះការងារជាបន្ទាន់គឺជម្រៅ មិនមែនផ្ទៃទូលាយថ្មីទេ៖ បន្ថែមស្នាដៃស្រាវជ្រាវនិស្សិតតាមអ៊ីនធឺណិត និងបង្កើតផ្លូវសិក្សាបន្ថែមលើឯកសារដែលមានស្រាប់។
មុខងារសំខាន់
ឯកសារប្រាំប្រភេទក្នុងកាតាឡុកតែមួយ
សៀវភៅឌីជីថល កាតាឡុកបណ្ណាល័យរូបវន្ត និក្ខេបបទនិស្សិត ស្នាដៃស្រាវជ្រាវ និងផ្លូវសិក្សាដែលបានរៀបចំ ដែលនីមួយៗមានទំព័របញ្ជី និងទម្រង់កំណត់ត្រារៀងៗខ្លួន។
ការស្វែងរក តាមប្រធានបទ និងតាមអ្នកនិពន្ធ
ទំព័រស្វែងរកដាច់ដោយឡែក ព្រមទាំងទំព័រប្រធានបទ និងអ្នកនិពន្ធដែលរុករកបាន ដូច្នេះអ្នកអានអាចរើទៅឯកសារជាប់ពាក់ព័ន្ធ ដោយមិនចាំបាច់ចាប់ផ្តើមឡើងវិញ។
អានក្នុង browser ទាញយកពេលមានសិទ្ធិ
កំណត់ត្រាសៀវភៅបើកចេញជាមួយការពិពណ៌នា ដោយមានផ្ទាំងអាន និងផ្ទាំងមតិយោបល់នៅជាប់គ្នា ហើយកំណត់ត្រានីមួយៗបញ្ជាក់អាជ្ញាបណ្ណ និងស្ថានភាពអានដោយសេរីរបស់ខ្លួន។
ផ្លូវសិក្សាដែលបានរៀបចំ
លំដាប់សៀវភៅ និងនិក្ខេបបទដែលរៀបចំជុំវិញប្រធានបទបណ្តុះបណ្តាលគ្រូជាក់ស្តែង ព្រោះបញ្ជីសៀវភៅវែងមិនមែនជាកម្មវិធីសិក្សាទេ។
កម្មវិធីដំឡើងបាន អានពេលគ្មានអ៊ីនធឺណិត
PWA ជាមួយ service worker ផ្លូវកាត់ដំឡើងទៅសៀវភៅ និក្ខេបបទ និងឯកសាររក្សាទុក ព្រមទាំង «រក្សាទុកសម្រាប់អានក្រៅបណ្តាញ» ជាទំព័រដាច់ដោយឡែក។
ភាសាខ្មែរ និងអង់គ្លេសស្មើគ្នាពេញលេញ
គ្រប់ផ្នែកសាធារណៈមានទាំងពីរភាសាក្រោម /km ដោយមាន hreflang យោងគ្នាក្នុង sitemap ហើយ URL អង់គ្លេសជា canonical។
Structured data និង llms.txt
Schema បែប Library, EducationalOrganization, WebSite, Book, ScholarlyArticle, FAQPage និង BreadcrumbList ព្រមទាំងឯកសារអត្ថបទសម្រាប់ប្រព័ន្ធ AI ដែលឆ្លើយសំណួរ។
បណ្ណាល័យរូបវន្ត ចងក្រងជាឯកសារ
បទបញ្ជា ម៉ោងបើក ឯកសារសម្រាំង គណៈកម្មការ ក្រុមការងារ និងប្រវត្តិបណ្ណាល័យតាំងពីឆ្នាំ ២០១៧ — ដូច្នេះសេវានៅនឹងកន្លែងជាផ្នែកនៃគេហទំព័រតែមួយ។
គណនីអ្នកអាន និងបញ្ជីរក្សាទុក
ការចូលគណនីតាម Google ជាមួយ Cloudflare Turnstile លើទម្រង់បំពេញ។ គណនីបន្ថែមប្រវត្តិរូប បញ្ជីឯកជន និងឯកសារក្រៅបណ្តាញ លើកាតាឡុកបើកចំហ។
ក្បាលឆ្លើយតបដែលពង្រឹងសុវត្ថិភាព
Content-Security-Policy ដែលរាយបញ្ជីដើមកំណើតដែលអនុញ្ញាតទាំងអស់, frame-ancestors none, form-action self, HSTS ជាមួយ preload និងទំព័ររដ្ឋបាលដែលមិនចូលក្នុងលិបិក្រម។
លទ្ធផលដែលបានវាស់
បង្ហាញតែលេខដែលមានប្រភពកត់ត្រាទុក។
- 114
- ឯកសារឌីជីថលដែលបានបោះផ្សាយ
- 5
- ប្រភេទឯកសារសាធារណៈ
- 151
- URL ដែលចូលលិបិក្រមបាន
- 2
- ភាសាផ្ទាំងប្រើប្រាស់
- 300s
- រយៈពេលធ្វើបច្ចុប្បន្នភាពទំព័រ
Reported by the platform itself in its public llms.txt: 112 e-books, 1 thesis, 1 publication.
កក្កដា 2026
Books, physical catalogue, theses, publications and learning paths — the five public sections listed in the sitemap and llms.txt.
កក្កដា 2026
Counted from the published sitemap.xml, each URL carrying reciprocal English/Khmer hreflang.
កក្កដា 2026
English and Khmer, with every public section available under both a canonical and a /km URL.
កក្កដា 2026
Read from the x-nextjs-stale-time response header on a prerendered catalogue page.
កក្កដា 2026